On voit passer des démonstrations très impressionnantes. Le plan d’une ville vue du ciel, construit à partir d’OpenStreetMap et de quelques consignes : on lance l’agent le soir, on regarde le résultat le lendemain matin. C’est réellement bluffant.
Un logiciel de gestion d’entreprise est une autre affaire. Ventes, achats, stock, comptabilité, salaires, heures, service après-vente : beaucoup de code, beaucoup de données, et des domaines qui dépendent les uns des autres. Les fonctions doivent tenir ensemble, les données rester cohérentes, et l’utilisateur doit pouvoir travailler sans connaître les arrangements du développeur. Ce genre de logiciel ne se juge pas au réveil, sur une impression d’ensemble.
Les agents produisent du code à une vitesse impressionnante. Cela ne dit pas encore si les modifications sont justes, si elles règlent le problème posé ou si elles en créent un dans le département voisin. Toute l’organisation décrite ici est née de ces questions.
D’où l’on regarde
Une formation d’informaticien de gestion enseigne d’abord un métier : traduire la demande d’un client en logiciel. Comprendre comment travaillent un comptable, un vendeur ou un magasinier, puis l’écrire de façon qu’une machine l’exécute sans trahir le besoin.
Le parcours a ensuite montré les deux côtés d’une équipe de développement. D’un côté, le développeur, membre d’équipes sur de gros systèmes. De l’autre, le responsable informatique : gestion de parcs, de serveurs et de réseaux, pilotage d’équipes de développeurs.
Ces deux côtés servent chaque jour avec les agents. Le développeur sait ce qu’un lot bien découpé facilite, et ce qu’une consigne floue produit. Le responsable sait qu’une équipe vaut ce qu’on contrôle, et qu’une annonce de fin de travail n’est pas une recette. Les agents ne changent pas ces principes. Ils obligent à les appliquer avec beaucoup plus de rigueur, parce qu’ils travaillent vite et ne doutent jamais.
Une année en quatre temps
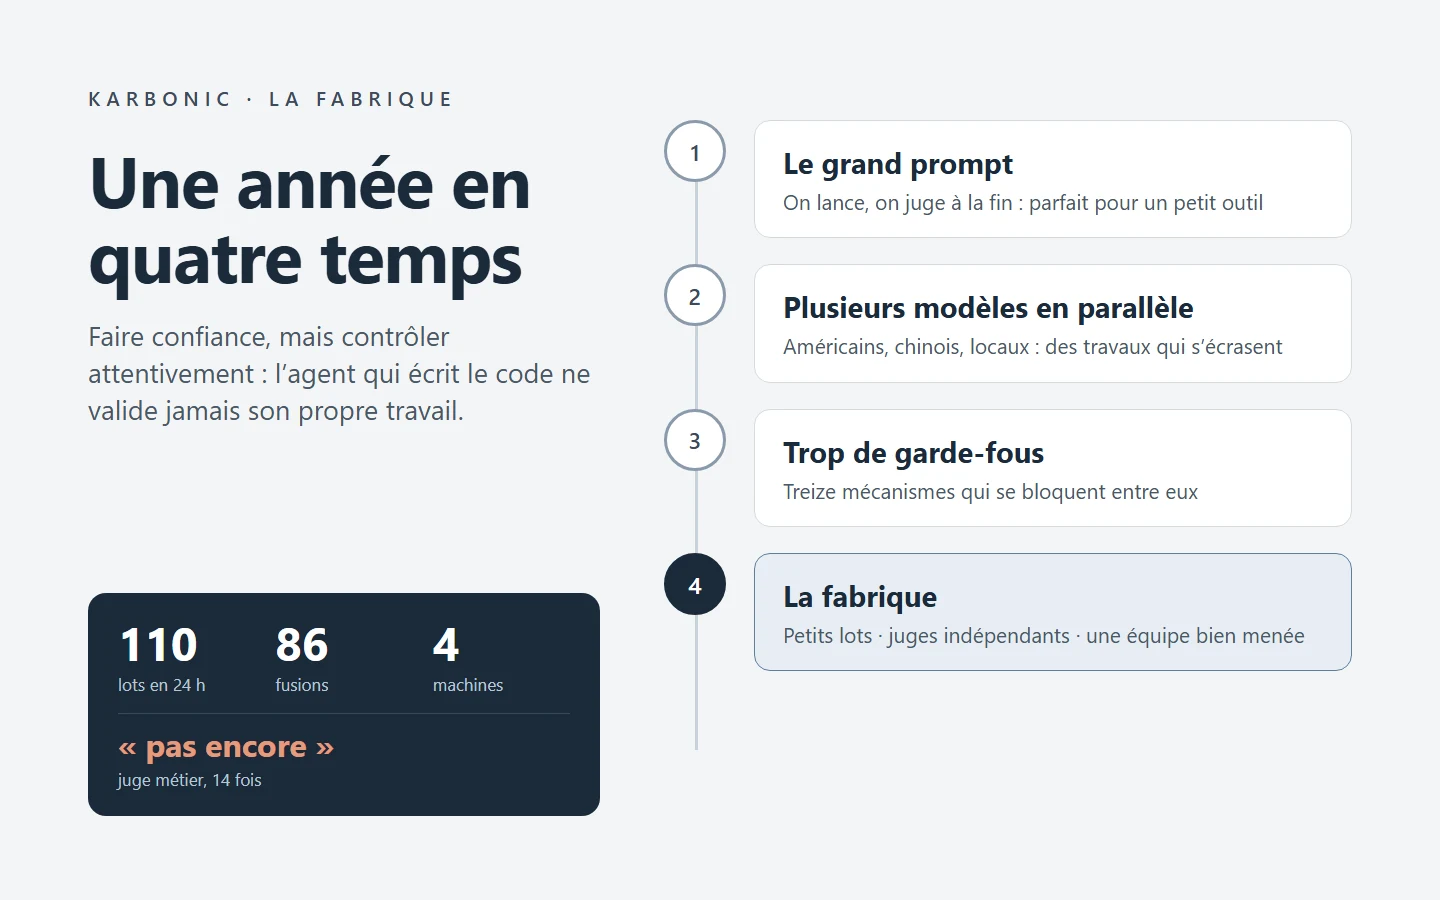
Le grand prompt. Comme tout le monde, on commence par un gros prompt, et on verra bien. On nous vendait alors des gestionnaires de prompts, et l’idée qu’il fallait avant tout devenir très fort en formulation. Pour une petite application, c’est parfait : « analyse cette facture et intègre-la » fonctionne très bien. Laisser un agent tout faire seul et juger à la fin ne tient plus dès qu’il faut traiter plusieurs domaines à la fois. Ce qui compte n’est pas la formule du prompt. C’est de garder une logique de réflexion d’un bout à l’autre : découper, ordonner, vérifier.
On a aussi vu fleurir des dépôts promettant un reverse engineering quasi magique d’un logiciel existant. Sur un progiciel de gestion, avec ses dizaines de tables et ses règles métier, la démonstration reste à faire. Peut-être faut-il être plus calé pour en tirer parti. L’expérience de l’atelier va dans un autre sens : c’est une bonne équipe, bien menée, qui commence à donner un résultat exploitable.
Plusieurs modèles en parallèle. Vient la phase où l’on essaie tout : Claude, Codex, Gemini, GLM, Kimi, Grok, DeepSeek au travers de DeepCode. Chacun a ses qualités. Certains modèles très capables et bon marché demandent un encadrement serré ; d’autres réfléchissent longuement là où un travail simple suffirait. Faire travailler plusieurs agents sur le même dépôt, sans règles communes, a produit des travaux qui se contredisaient ou s’écrasaient.
Trop de garde-fous. La réponse naturelle a été d’encadrer. Gardes, juges, cliquets, orchestrateurs, moniteurs : jusqu’à treize mécanismes ont coexisté, et ils ont fini par se bloquer entre eux. Une garde refusait toutes les fusions à cause d’une erreur de comptage ; un orchestrateur a tourné à vide jusqu’à remplir le disque. Il a fallu élaguer.
La fabrique. L’organisation actuelle est plus simple : de petits lots, des agents interchangeables chacun dans son périmètre, des juges indépendants, un pilote qui distribue et un rapport lisible. Elle tourne sur quatre machines, de jour comme de nuit. La conversation avec un modèle ne sert plus qu’aux décisions.
En chantier, avec des avancées presque chaque jour : OpenClaw et Hermes, pour relier les agents entre eux et leur donner une mémoire commune.
Ce que les modèles frontières font très bien
Écrire du code, bien sûr. Mais un de leurs talents les plus utiles est ailleurs : se mettre à la place de quelqu’un. « Bonjour, je suis Martine, comptable depuis vingt ans. Je dois saisir les factures fournisseurs du mois et préparer le bouclement. » Un modèle frontière tient ce rôle avec une justesse surprenante. Il cherche les fonctions là où une comptable les chercherait, s’agace des mêmes détours, et relève ce qui l’empêche de finir son travail.
C’est cette capacité qui fait aujourd’hui le juge persona de l’atelier, décrit plus bas. Elle ne remplace pas les tests techniques. Elle mesure autre chose : est-ce qu’une personne du métier peut travailler avec ce logiciel ?
Quel modèle pour quelle donnée
Le choix d’un modèle ne se fait pas seulement sur ses performances. Il dépend d’abord de ce qu’on lui confie. Il n’y a aucune raison de transmettre des données confidentielles à un modèle américain, ni à un modèle chinois. Il y en a beaucoup, en revanche, de profiter de leur puissance pour écrire du code ou traiter une image sans enjeu.
Le classement retenu tient en trois niveaux :
| Nature de l’information | Où elle est traitée | Exemples |
|---|---|---|
| Confidentielle : dossiers juridiques, comptabilité, salaires, images d’une entreprise | En local, sur les machines de l’atelier | Synthèse de dossiers, imagerie produit |
| Professionnelle, sans secret, mais qui doit rester en Suisse | Modèles hébergés en Suisse (Infomaniak) | Lecture de factures, assistant intégré au logiciel |
| Code source, données de test fictives | Modèles frontières, américains ou chinois | Écriture et correction du code, simulations métier, audits |
Chaque modèle a ses avantages et ses inconvénients, et tout progresse à très grande vitesse : le meilleur choix d’il y a trois mois ne l’est souvent plus. D’où l’intérêt de ne dépendre d’aucun, et celui des modèles à poids ouverts, que l’on peut héberger, examiner et spécialiser soi-même.
L’IA locale : une année d’essais
Les documents. ClearMyDocs, le moteur de synthèse documentaire de l’atelier, a servi de premier banc d’essai. Début 2026, sur une carte graphique de 8 Go, plusieurs petits modèles ont été comparés sur un vrai dossier juridique de cinquante documents. Certains ne tenaient tout simplement pas en mémoire. D’autres tournaient, mais produisaient un texte abondant et peu fiable, ou lisaient le mauvais document. Les plus petits gagnaient en vitesse ce qu’ils perdaient en précision.
Le banc a ensuite été complété par une référence haute : un modèle nettement plus grand, hébergé en Suisse, pour savoir à quoi ressemble le possible sur la même tâche. On a aussi quitté Ollama pour llama.cpp, afin de maîtriser exactement ce qui est envoyé au modèle, sans gabarit caché.
La leçon la plus utile n’est pas venue des modèles. Lors d’un essai, une suite de délais dépassés a vidé les axes de recherche, et la chaîne a déclaré une couverture de 100 %… sur zéro axe. Elle s’est arrêtée après avoir lu un seul document, tout en se disant complète. Changer de modèle n’y aurait rien changé. Il a fallu revoir la chaîne, puis ajouter un contrôle déterministe : chaque fait extrait est vérifié contre la pièce source avant d’entrer dans une synthèse.
Depuis environ six mois, ClearMyDocs v4 travaille avec un modèle de taille modeste, qui se charge correctement sur du matériel courant et qui traite de la vraie donnée sans « rendre de la confiture ». Le même moteur peut aussi s’appuyer sur un modèle hébergé en Suisse ou sur un modèle frontière, sans changer le reste. Le contrôle de fidélité, lui, ne dépend d’aucun modèle, ce qui permet de les comparer honnêtement sur un même dossier.
Le code. Les cartes graphiques grand public de 8 à 12 Go, réparties sur plusieurs machines, accueillent des modèles réduits et quantifiés, utiles pour des tâches courtes. Un modèle de code sérieux n’y tient pas. D’où l’achat d’un mini-PC à 128 Go de mémoire unifiée, installé sous Fedora avec llama.cpp.
Sur ce type de machine, c’est le débit de la mémoire qui limite, pas sa taille. Un grand modèle dense, de 70 milliards de paramètres, y produit quelques mots par seconde : inutilisable dans une boucle d’agents. Les modèles à mélange d’experts (MoE) changent la donne : tous leurs poids tiennent en mémoire, mais seule une petite partie travaille pour chaque mot produit. Au terme d’une série d’essais, Qwen3 Coder Next a été retenu, branché sur OpenCode.
Il traite de petits lots courts et bornés, et il fait partie de l’équipe comme les autres agents : onze lots sur les dernières vingt-quatre heures. Il ne remplace pas les modèles hébergés sur les gros chantiers, où il faut relire beaucoup de fichiers très vite. Il prend sa part du travail courant, sans abonnement, et rien ne sort de la maison.
La piste suivante : confier une partie des simulations métier à un modèle local, avec un modèle frontière en juge de second niveau. Le critère est fixé d’avance : si le local relève au moins 80 % des défauts trouvés par le modèle frontière sur une même simulation, il prend la relève.
L’entraînement. Des essais de LoRA sont en cours. Ces petites couches d’adaptation spécialisent un modèle sans le réentraîner entièrement. L’idée est d’apprendre au modèle local ce qui a déjà été jugé bon : le code accepté, les écrans validés, un produit à représenter sans déformation. Cadrer le travail en amont, plutôt que se faire recaler en aval.
Un flux d’image automatisé
L’autre grand chantier local concerne la photo produit, en horlogerie. Le but est d’automatiser le geste d’un retoucheur professionnel : prendre la photo officielle d’une montre et l’intégrer dans une scène (posée sur un comptoir, sur du bois, sur l’eau), sans jamais déformer un chiffre du cadran, une aiguille ou un maillon. Les images d’une entreprise ne doivent pas sortir : tout tourne en local.
Le flux reprend l’ordre du travail manuel dans Photoshop :
- Détourer, pièce par pièce : cadran, boîtier, cornes, couronne, maillons.
- Un calque par objet, avec des pixels contigus, comme un retoucheur le ferait.
- Positionner, puis déformer : angle, perspective, réduction du nombre de maillons.
- Retraiter la matière seulement là où elle n’est pas propre, un brossé mal détecté par exemple.
- Placer dans la scène, à la bonne taille.
- Ombres et rééclairage.
Chaque étape a son outil. Pour le détourage, CLIPSeg s’est révélé trop grossier, mais reste utile pour repérer les zones. SAM 2.1 et BiRefNet donnent un détourage fin, bords métalliques compris. La génération des décors et l’édition passent par ComfyUI, piloté sans interface au travers de son API, avec plusieurs familles de modèles essayées tour à tour : SDXL avec ControlNet, FLUX.2, Qwen-Image. Blender est automatisé par script. Il ne modélise pas la montre : il calcule la lumière, les ombres, les reflets et la géométrie du positionnement. OpenCV applique les déformations.
Les juges sont fixés avant tout réglage. Une comparaison pixel par pixel vérifie que le cadran n’a pas bougé par rapport à l’original. Un modèle de vision juge si la scène est crédible. Si on ne lit pas les chiffres, ou si la montre ne paraît pas réelle, l’image ne passe pas.
Les erreurs ont été instructives. Un modèle génératif à qui l’on laisse la géométrie invente la forme : un boîtier plausible, mais faux. Recoller les vrais pixels ligne par ligne produit l’inverse : des déchirures et une « soupe de pixels ». La bonne unité de travail est l’objet, comme pour un retoucheur. Autre leçon : les licences changent d’une version à l’autre. Un modèle publié en licence libre peut revenir dans sa version suivante en licence de recherche, non commerciale. On vérifie avant d’intégrer.
Ce flux est encore un prototype. Il obtient déjà des mises en scène réalistes, mais pas encore la régularité d’un flux de production. La méthode, en revanche, est la même que pour le code : des étapes protocolées, des juges fixés d’avance, et un journal de ce qui marche et de ce qui ne marche pas.
Le circuit actuel
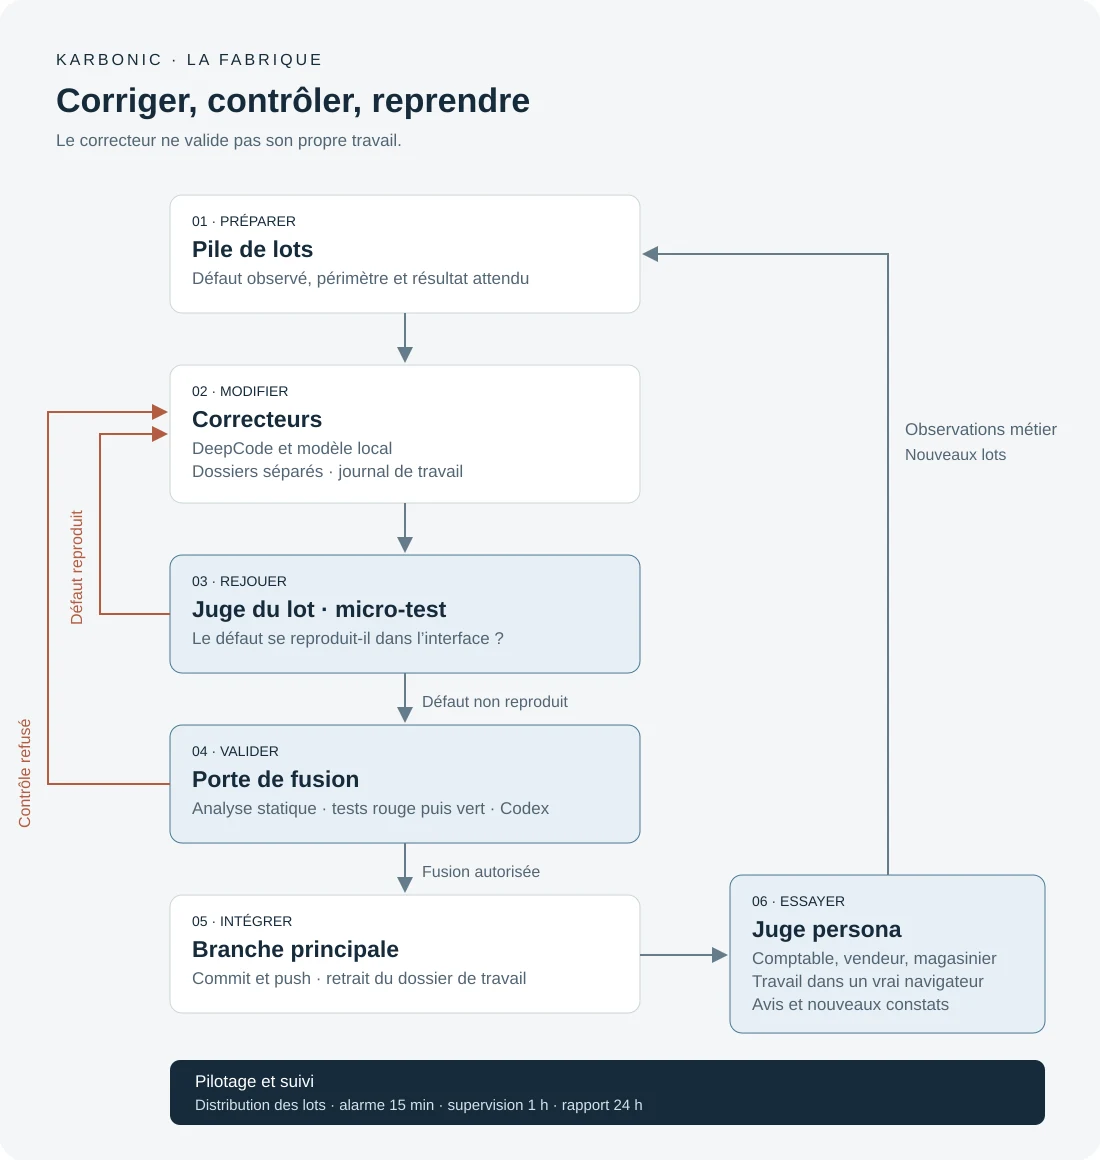
La pile de lots. Chaque secteur du logiciel dispose d’une matrice de contrôle. Une case qui ne passe pas devient un lot : un objectif décrit du côté de l’utilisateur, un constat mesuré, et les fonctions voisines qui doivent rester opérationnelles. Les pistes techniques sont notées comme des hypothèses, que les observations peuvent écarter. Le lot reste petit, même lorsque le contexte fourni à l’agent est large. « Refais le module » laisse trop de place à l’interprétation et rend le résultat impossible à contrôler.
Les correcteurs. DeepCode assure l’essentiel des corrections sur deux machines dédiées ; le modèle local prend les petits lots. Chaque agent travaille dans son propre dossier et dans un périmètre de fichiers défini. Il consigne ce qu’il fait pendant le travail, pas seulement à la fin : si la session s’arrête, les tentatives et les résultats intermédiaires restent disponibles. Une boîte aux lettres commune, que chacun lit avant de commencer, remplace les consignes répétées.
Le micro-test. Un agent qui annonce avoir terminé fournit un rapport, pas une validation. Le correcteur ne ferme donc jamais son propre lot. Un autre agent rejoue d’abord le défaut dans l’interface : environ cinq minutes, contre quarante-cinq pour un passage complet. Si le problème se reproduit, le lot retourne au correcteur.
La porte de fusion. Elle rassemble l’analyse statique, les tests et un verdict rendu par Codex. Un test censé couvrir le défaut doit avoir été vu en échec avant la correction, puis réussir après. Sans cette contre-épreuve, il peut passer sans rien détecter. Après validation, la modification rejoint la branche principale et le dossier de travail est retiré.
Le juge persona. Une série de corrections validées ne prouve pas qu’un logiciel est utilisable. Régulièrement, un modèle prend le rôle d’une comptable, d’un vendeur ou d’un magasinier et utilise le logiciel dans un vrai navigateur. Il reçoit un travail à accomplir, sans qu’on lui demande d’être indulgent. Son avis porte sur ce qu’il a pu faire, et sur ce qui l’en a empêché. Ses observations redeviennent des lots. De temps en temps, un juge neuf, qui ignore tout de l’historique, repasse derrière les juges en place : ceux-ci finissent parfois par accepter une difficulté simplement parce qu’ils l’ont déjà vue.
Le pilote. Sur le poste principal, un pilote distribue les lots. Une alarme sans IA vérifie tous les quarts d’heure qu’aucun processus n’est tombé en silence ; un superviseur passe chaque heure ; un rapport rassemble les dernières vingt-quatre heures. Les dépôts Git, les branches et les résultats des contrôles donnent accès au détail : on doit pouvoir retrouver pourquoi une modification a été acceptée ou refusée, sans relire des dizaines de conversations.
Ce qui a coûté du temps
L’équipe décrite en YAML. Les premiers essais décrivaient toute l’organisation dans des fichiers YAML : gestionnaire de prompts, secteurs, responsables, développeurs, juges. Sur le papier, tout y était. Ça n’a pas marché.
L’agent chef. Un agent chargé de réfléchir pour tous les autres et de répartir leur travail n’a jamais donné de résultat satisfaisant. Un pilote qui distribue des lots précis est utile ; lui confier toute la compréhension du projet ne l’est pas.
Les scores. « 1 980 tests sur 1 983 » ne dit pas si les trois échecs empêchent de travailler, ni si les autres tests vérifient ce qui compte. La liste des blocages, avec leur cause, est bien plus utile pour décider de la suite.
Les changements d’orchestrateur. Une passation à un autre modèle en cours de chantier a consommé l’essentiel d’un quota pour une avancée minime. Reconstituer la compréhension d’un projet en cours coûte plus cher qu’on ne l’imagine.
Les tests qui ne cliquent pas. Un test qui interroge l’API peut réussir alors que l’écran est cassé. Il garde son intérêt pour les traitements, mais un parcours utilisateur se valide dans l’interface.
Ce qui tient
- Des lots petits, chacun dans son périmètre, avec un contrat d’entrée et de sortie.
- Les instruments de mesure d’abord, les corrections ensuite : un rapport douteux engendre des lots douteux.
- Après deux essais infructueux sur un même défaut, on instrumente le code pour qu’il désigne lui-même l’endroit où il casse.
- Les juges et leurs seuils sont fixés avant de régler quoi que ce soit.
- La validation se fait sur une installation neuve, pas sur une base réparée à la main au fil des semaines.
- On commite et on pousse souvent ; aucun dossier de travail ne reste orphelin.
- Aucune machine ne reste au repos tant qu’il reste des lots prêts.
Vingt-quatre heures de travail
Du 11 novembre au matin au 12 novembre au matin, quatre machines ont lancé 110 lots et produit 86 fusions. Quatre-vingt-cinq de ces lots provenaient directement des observations du juge persona.
Le juge est passé quatorze fois, sur huit secteurs. À chaque passage, son avis est resté : pas encore utilisable. C’est exactement son rôle.
Cette mesure porte sur une journée d’activité, pas sur un gain de productivité comparé à une équipe humaine. Elle montre le volume de travail possible, et l’écart qui peut subsister entre ce volume et un produit prêt à servir.
Pour qui démarre
- Se méfier du grand prompt. Il convient à une petite application. Au-delà, c’est le découpage qui fait le résultat, pas la formule.
- Commencer par le découpage, pas par le modèle. Un bon lot avec un modèle moyen donne de meilleurs résultats qu’une consigne floue avec le meilleur modèle.
- Ne jamais laisser un agent valider son propre travail. Un second agent, ou un humain, constate.
- Tester comme un utilisateur. Cliquer, lire l’écran, faire le travail demandé ; un modèle frontière qui joue la comptable le fait très bien.
- Faire écrire l’état. Un agent ne se souvient de rien ; il ne sait que ce qui a été écrit.
- Choisir le modèle selon la donnée, puis selon la tâche et le coût.
- Mesurer le local avant d’y croire. La taille de la mémoire et son débit décident de ce qui tourne vraiment.
- Alléger régulièrement les contrôles. Un garde-fou qui bloque sans raison coûte autant qu’un bug.
Partageons nos expériences
Après une année, la production de code a changé d’échelle. Le travail d’encadrement a changé avec elle : préparer les lots, entretenir les contrôles, examiner les retours métier, décider des priorités. C’est, au fond, le métier d’informaticien de gestion : traduire un besoin en logiciel, et vérifier que le logiciel répond bien au besoin.
Ce dispositif n’est pas figé, et il s’est construit en bonne partie sur les erreurs. Beaucoup d’équipes et d’indépendants mènent aujourd’hui les mêmes essais, chacun dans son coin. Comparer nos méthodes ferait gagner du temps à tout le monde : comment vous organisez vos agents, comment vous jugez leur travail, quels modèles vous gardez en local et pourquoi, ce qui a marché et ce qui a échoué. Les retours d’expérience sont les bienvenus.
Pour votre projet
Logiciel de gestion, documents, IA locale ou hébergée en Suisse : nous partons de vos données et de leur sensibilité, puis nous choisissons les outils.